
METAMATEMÁTICO — Razonamiento Formal con Lean 4



Leonardo Jiménez Martínez · BIOMAT · Centro de Biomatemáticas
Una IA matemática que no confía en el modelo de lenguaje para decidir si algo es cierto. El LLM formaliza en Lean 4, el kernel verifica, y sólo entonces se traduce el resultado.
Alrededor de esa cadena hay dos capas de conocimiento con trabajos distintos: un grafo pequeño y curado que dice de qué habla algo, y una lista grande y extraída de Mathlib que dice qué es cierto. Ninguna de las dos decide la verdad — eso es Lean, siempre.
Documentación visual completa — Metamatemático por dentro: las dos capas, el grafo dibujado, la arquitectura de hoy, lo que está medido, lo que se midió y se quitó, y los instrumentos rotos que hubo que cazar por el camino. Fuente en
docs/arquitectura_nle.html.
Índice
- El flujo, de la entrada a la salida
- Las dos capas
- El grafo: de qué consta
- La lista: 183 433 hechos
- Lean: cuatro caminos, ocho veredictos
- Lo que está medido
- El lazo por pasos
- Tests y guardianes
- Lo que se midió y se quitó
- El flujo de trabajo
- Instalación y uso
- Estructura del repositorio
- Lo que no está
1. El flujo, de la entrada a la salida
Todo pasa por Nucleo.process(texto). Los alumnos preguntan en español y
todo el aparato es inglés, así que el flujo empieza y acaba en una frontera de
idioma.
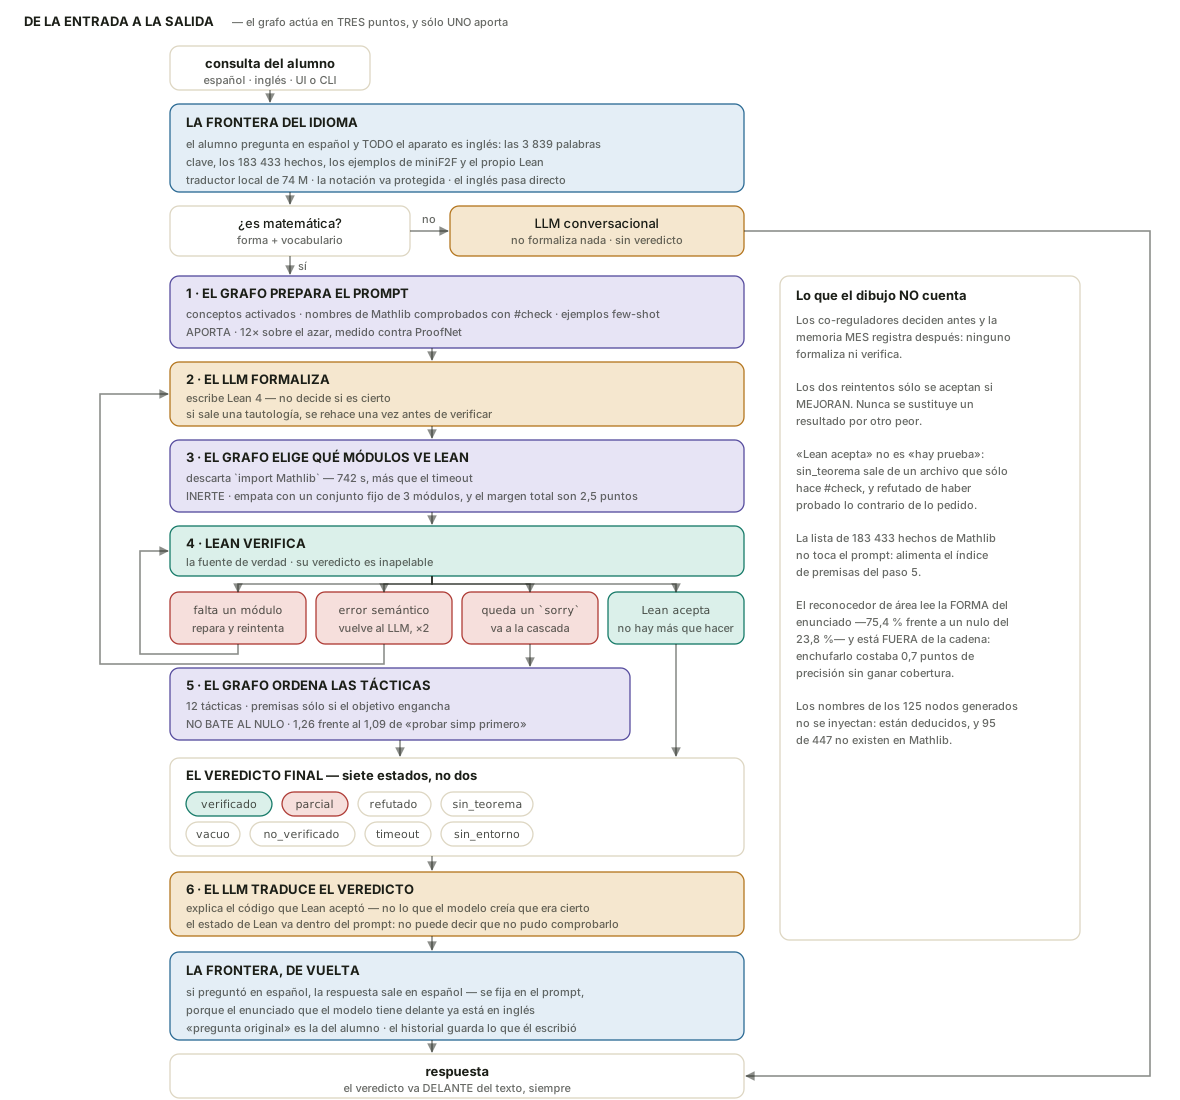
| paso | quién | qué hace | ¿aporta? |
|---|---|---|---|
| 1 | grafo | nombres de Mathlib verificados al prompt | sí — 16,5× sobre el azar |
| 2 | LLM | escribe Lean 4 — no juzga si es correcto | — |
| 3 | grafo | el módulo de cada nombre que el paso 1 ofreció | imprescindible — sin él, 282 de 284 |
| 4 | Lean | verifica · su veredicto es inapelable | — |
| 5 | cascada | 12 tácticas si queda un sorry, en una sesión viva de Lean | sí — los fallos, 276 s → 40,4 s |
| 6 | LLM | traduce el código que Lean aceptó | — |
La última columna sale de medir cada punto por separado. No hay un veredicto único sobre «el núcleo»: el vocabulario del prompt aporta, el módulo de cada nombre ofrecido es imprescindible, y lo que el grafo hacía después de la frontera —proponer módulos vecinos, ordenar las tácticas por área— se midió, no batió a su nulo y ya no está en el código. El detalle está en la sección 6 y los negativos, con su cifra, en la 9.
La frontera del idioma
Los seis pasos no llevan idioma propio: lo llevan sus datos, y son todos ingleses — las 4 302 palabras clave del grafo, los 183 433 hechos de Mathlib, los ejemplos few-shot de miniF2F y el propio Lean. Un alumno que escribe «¿Es 17 un número primo?» no toca ninguna de esas palabras.
Así que la consulta se traduce una vez, al entrar, con un modelo local
(Helsinki-NLP/opus-mt-es-en, 74 M de parámetros, sin API), y el inglés pasa
directo.
                            antes    después
activan alguna skill         9/24      11/24     ← 24 consultas reales
abren alguna área            3/24       9/24
La notación se protege, y no era opcional. Medido sobre el modelo desnudo:
$x^2 - 5x + 6$          →  $x^2 - 5x + $6
\mathbb{R}$             →  \mathbb{R$
\int_0^\infty ... dx$   →  int_0=infty ... dx$    (destruido)
\sin x                  →  \without x
El último lo explica todo: \sin es el seno, y «sin» en español es una
preposición. Se saca la notación, se sustituye por marcas que sobreviven al
tokenizador, y se devuelve a su sitio.
Y la frontera se cruza de vuelta. Si preguntó en español, la respuesta sale en español — hay que fijarlo en el prompt, porque el enunciado que el modelo tiene delante ya está en inglés y una instrucción como «responde en el mismo idioma que el usuario» le haría contestar en inglés. Lo que se le enseña como «pregunta original» es la suya, no la traducción, y el historial guarda lo que él escribió.
2. Las dos capas
| el grafo | la lista | |
|---|---|---|
| qué guarda | conceptos — de qué habla | hechos — qué es cierto |
| tamaño | 353 nodos | 183 433 entradas |
| cómo se hizo | 206 a mano + 125 generados | extraída del fuente, entera |
| ¿puede equivocarse? | sí — es curación humana | no sobre sí misma |
| estructura | categórica: colímites, orden, pilares | plana, indexada |
| en el flujo | pasos 1 y 3 — el 3 reusa el emparejamiento del 1 | alimenta el índice de premisas, y se alcanza por classify_query, no por el grafo |
El puente existe en los datos, pero no está tendido en el código. Cada
hecho de la lista lleva su concepto —Algebra.Order, Data.Set— y ésos son
exactamente los identificadores de los 125 nodos generados. La correspondencia
no hay que inventarla: está en la ruta del módulo.
Pero en el runtime las dos capas no se hablan. Medido: nucleo/lean/premisas.py
tiene cero menciones del grafo. Su único parámetro de contexto es un nombre de
área, y ese nombre sale de classify_query() — un clasificador de palabras clave
que no toca el grafo en ningún punto.
Y tenderlo al grafo lo empeoraría, que es la parte que no era obvia. Medido sobre 3 000 consultas etiquetadas, con su modelo nulo al lado:
| exactitud cruda | exactitud equilibrada | |
|---|---|---|
classify_query | 60,3 % | 62,1 % |
| área de la 1ª skill del grafo | 30,4 % | 38,9 % |
| nulo: responder siempre «algebra», sin leer el enunciado | 88,6 % | 33,3 % |
El nulo es la fila que hay que mirar primero, y durante meses no estuvo puesta:
el banco es 89 % algebra, así que una constante gana a las dos medidas en
crudo. La cifra que dice algo es la equilibrada —la media de los aciertos
dentro de cada área—, donde el nulo se hunde al 33,3 % y classify_query se
pone veinticinco puntos por encima.
La conclusión no cambia, se refuerza: conectar la lista al grafo sería cambiar el clasificador bueno por el malo, y con la medida honesta la distancia entre los dos es mayor (62,1 contra 38,9), no menor. Lo que falta no es el cable, es un motivo medido para tenderlo.
Por qué hacen falta las dos
Medido: de los 169 nombres que el grafo inyecta hoy, 3 son teoremas o lemas y 166 son tipos, estructuras y clases. El grafo da los sustantivos.
Y ahí no es donde el modelo falla. De los 28 nombres que propuso de memoria, los
21 inexistentes eran todos lemas — tsum_geometric_two, Subgroup.isCyclic,
isOpen_union. El modelo acierta razonablemente los sustantivos e inventa los
hechos. La lista existe para cubrir esa mitad.
Y la otra mitad estaba casi vacía. El extractor de hechos justificaba dejar
fuera def, structure y class con «son sustantivos y ya los cubre el
grafo». Contado sobre el fuente: Mathlib tiene 34 084 sustantivos y el
grafo inyecta 169 — el 0,50 %. La frase estaba equivocada por un factor de
200, justo en la mitad donde el reparto dice que el grafo aporta.
data/sustantivos_mathlib.jsonl la construye, y los nombres se leen de la
declaración en vez de deducirse de la ruta: #check sobre una muestra da
200 de 200 existentes, frente al 77,4 % de los deducidos. Lo que no
funciona es la vía de inyectarlos — el módulo de un nodo generado es un rincón
de su área, y a volumen igualado pierde. Está medido en §7 del reporte.
3. El grafo: de qué consta
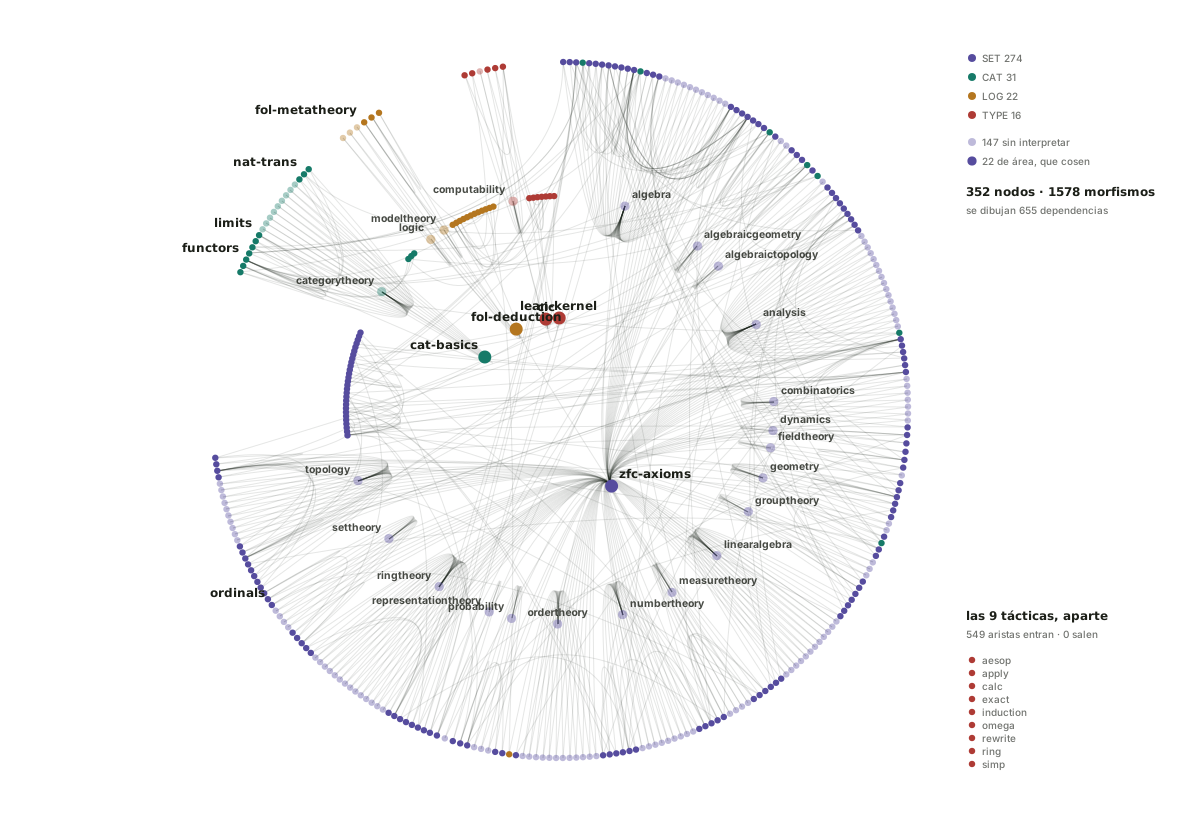
| pieza | cuántos | qué es |
|---|---|---|
| nodos curados | 206 | con veredicto categórico: «un objeto es un grupo, las flechas son homomorfismos» |
| nodos de área | 22 | la puerta de entrada: Algebra, Topology, OrderTheory… Entrar por una poda a 10 nodos de mediana |
| nodos generados | 125 | leídos de la taxonomía de Mathlib. Dicen dónde vive algo, no qué es. Marcados interpretado=False |
| dependencias | 688 | prerrequisitos, y acíclicas: eran 1156 con 4 ciclos, el mayor de 80 nodos |
| traducciones | 538 | entre pilares — Curry-Howard, conjuntos↔categorías |
| analogías | 7 | correspondencias débiles, marcadas como tales |
| identidades | 353 | una por objeto, como exige la definición de categoría |
python scripts/dibujar_grafo.py # regenera la figura desde el grafo real
Las nueve tácticas son sumideros
tactic-simp, tactic-ring y las otras siete reciben 453 aristas y no emiten
ninguna. Por eso están dibujadas aparte: dentro convertían el grafo en un
embudo donde cualquier recorrido terminaba.
Es una categoría-error del mismo tipo que se corrigió con la homología. Una táctica no es una cosa, es una transformación de estado de prueba: como nodo es un sumidero, como flecha compondría y tendría dominio y codominio. Identificado y sin arreglar.
Eran dos grafos, y ahora son uno
Medido: cero aristas entre los 174 curados y los 125 generados, sin contar
el enganche al pilar. mathlib-linearalgebra-basis alcanzaba 81 nodos hacia
arriba y ni uno era curado — no pasaba por linear-algebra, ni por
module-theory, ni por ring-theory, que existen.
La jerarquía ya estaba escrita en el anidamiento de módulos de Mathlib, y va
de lo general a lo especial — la misma dirección que el grafo curado seguía con
group-theory → ring-theory → field-theory.
                              antes    después
aristas que cruzan                0        125
generados con ancestro común   0/125    109/125
la lógica alcanza               158     278 de 320
Dos de esas cifras bajaron al arreglar la puerta, y es correcto que bajen.
124 de 125 se midió cuando el grafo tenía 4 ciclos y una componente fuerte de
80 nodos: casi todo alcanzaba a casi todo. Los 16 que ahora no llegan a un área
con curados están en computability, logic y ordertheory, que no tienen
ni un solo nodo hecho a mano. Es un hueco de los 174 curados, y ahora se ve.
Y faltaba fol-deduction → zfc-axioms: ZFC es una teoría de primer orden,
sus axiomas son fórmulas de primer orden con igualdad. Sin esa arista, media
matemática del grafo no tenía la lógica detrás. Una arista en vez de
trescientas. Es curada, no derivada — Mathlib no construye ZFC sobre
Logic.Basic.
Lo que el esqueleto no da: generados y curados son hermanos bajo un área,
no descendientes. La profundidad del módulo no ordena la generalidad —
LinearAlgebra.Basis está a profundidad 2 y LinearAlgebra.Matrix.Defs a 3, y
sin embargo el álgebra lineal es más general que la noción de base.
El grafo tiene ciclos, y no son de la matemática
134 ciclos, todos entre los nodos generados; entre los 174 curados hay cero. Y la causa es la agregación: el DAG oficial de Mathlib es acíclico —Lean prohíbe imports circulares— pero al colapsar 7 747 módulos en conceptos de dos niveles, aparecen.
Topology.Instances → Analysis.Asymptotics → Analysis.Complex → Topology.Instances
Son tres desarrollos distintos, no un recorrido. El ciclo marca dónde la división en ramas deja de funcionar.
Un resultado negativo sobre las «áreas». Se intentó definirlas por componentes fuertemente conexas, para que el corte lo dictara la estructura. No funciona: da una mega-área con 918 de los 1 358 conceptos. A nivel de fichero Mathlib es un DAG limpio; en cuanto se agrupa por ramas, casi todo queda entrelazado. La descomposición en ramas no es recuperable de las dependencias — el orden de construcción no respeta la frontera entre álgebra, topología y análisis.
Lo que ve el alumno de su propia consulta
En Visualizaciones → Traza, el alumno ve el subgrafo que el sistema asignó a la consulta que acaba de hacer en el chat: qué nodos enganchó, de qué dependen y a qué tácticas de Lean llegan.
Dos cosas que la vista dice en voz alta y antes callaba:
De dónde sale la subred. Son tres casos y no dan igual, así que van etiquetados: tu consulta del chat —los nodos exactos que se usaron para responder—, consulta nueva —se le pregunta al emparejador real del núcleo— o simulación —el núcleo no está arrancado y sale de un mapa de palabras de la propia página—. Antes caía al tercer caso en silencio, así que se podía estar mirando una subred que el sistema no calculó nunca.
Qué llegó al prompt. El dibujo enseña qué se activó; debajo hay una tabla con qué se ofreció, que es otra cosa y es donde el grafo se juega su medida. De los nodos enganchados sólo unos pocos ganan una de las plazas del prompt: los demás enrutan y se callan — las 33 ramas, por diseño, no aportan ningún nombre. Que un nodo se active no significa que hable.
Colores. El fondo es casi negro, así que un color oscuro no queda feo: desaparece.
tests/test_contraste_visualizaciones.pyexige 3,0:1 contra el fondo —el mínimo de WCAG para gráficos—, que ninguna arista repita el color de un nodo, y que la figura no escriba colores sueltos fuera de la paleta. Cazó tres fallos al estrenarse: las aristas de dependencia iban a 2,51:1 —las más numerosas, o sea que la estructura era lo que peor se veía—, las de analogía usaban el mismo verde que los nodos-táctica, y las etiquetas se dibujaban centradas sobre el nodo, ilegibles sobre el dorado.
4. La lista: 183 433 hechos
121 756  theorem        54 MB en disco
 50 835  lemma          1 102 conceptos distintos
 10 842  instance       3 sin enunciado utilizable (0,0 %)
python scripts/construir_lista_lemas.py --escribir
python scripts/construir_banco_lemas.py          # el banco de evaluación
El DAG oficial, que no hubo que reconstruir
Mathlib trae la herramienta hecha, en .lake/packages/importGraph:
| comando | qué da |
|---|---|
lake exe graph | el DAG completo — 21 446 aristas, 7 747 módulos, 0 ciclos |
#min_imports | los imports mínimos que necesita una declaración |
#find_home | en qué módulo debería vivir una declaración |
#import_diff | diferencia entre dos conjuntos de imports |
Al compararlo con el extractor propio apareció un fallo: el lector del fuente metía unas 2 800 aristas falsas y con ellas un ciclo imposible de 1 255 módulos. El oficial da cero, como debe.
Mathlib no etiqueta por rama — etiqueta por táctica
Se buscó una anotación de área y no existe. Lo que sí hay, en 83 111 líneas y 162 atributos distintos, es qué herramienta puede usar cada lema:
@[simp]        40 736      @[gcongr]       575      @[continuity]  255
@[norm_cast]    2 257      @[grind]        547      @[mono]        244
@[fun_prop]     1 796      @[aesop]        286      @[measurability]
Es un índice herramienta → lemas curado por los mantenedores, y sirve: el
42,1 % de las premisas que citan las pruebas ya llevan @[simp], y simp
las conoce sin que nadie se las pase. Filtrarlas movió la selección de premisas
de empatar con un prior de frecuencia (9,4 % contra 9,2 %) a superarlo
(14,0 % contra 11,7 %).
5. Lean: cuatro caminos, ocho veredictos
Hay que separar dos cosas que se confundían. Lo que Lean dice abre cuatro caminos, y tres de ellos siguen trabajando; sólo al final hay un veredicto.
| lo que dice Lean | qué pasa después |
|---|---|
| falta un módulo | se repara el encabezado y se reintenta una vez |
| error semántico | el error vuelve al LLM, máximo 2 rondas |
queda un sorry | entra la cascada de 12 tácticas, sobre la sesión viva de Lean |
| acepta el archivo | pasa directo al veredicto |
Los dos reintentos sólo se aceptan si mejoran: nunca se sustituye un resultado por otro peor.
Y que Lean compile no significa que haya demostrado lo que se preguntó. El veredicto final tiene ocho estados, y va delante del texto.
| veredicto | qué significa |
|---|---|
verificado | hay teorema, lo prueba, y es el que se preguntó |
parcial | la estructura compila; la cascada intentó cerrar el sorry |
refutado | Lean verificó la negación del enunciado |
sin_teorema | Lean aceptó el archivo, pero no contiene ningún teorema |
vacuo | hay teorema y compila, pero su conclusión es True: no dice nada |
no_verificado | Lean rechazó y los reintentos no lo arreglaron |
timeout | Lean no terminó dentro del límite |
sin_entorno | no hay lake instalado — no es un fallo de lógica |
sin_teorema, refutado y vacuo existen porque los tres se dieron: el sistema llegó a estampar
«verificado» sobre un archivo de #check sin teoremas, sobre la negación de lo
que se había pedido, y sobre theorem t : True := trivial — que compila con
exit 0 y sin una sola línea de salida. Ninguna la encontraron los tests: las dos
primeras las encontró correr el sistema contra un banco de consultas reales, y la
tercera una auditoría del camino del veredicto.
6. Lo que está medido
Cada cifra con su método y su modelo nulo. Sin modelo nulo un porcentaje no dice nada: 61 % de acierto suena bien hasta que se sabe que responder siempre lo mismo acierta el 79 %.
| qué | resultado | modelo nulo | veredicto |
|---|---|---|---|
| Vocabulario contra ProofNet 371 ejercicios con formalización de oro · concepto, k=2 | 23,9 % precisión 16,5 % cobertura | 1,45 % 3,3 % | 16,5× · aporta |
| Dependencias curadas contra el DAG real 151 aristas skill→skill medibles · DAG de 24 209 aristas | 72,2 % confirmadas 109/151 | 30,7 % nulo emparejado | 2,35× · aporta |
| Costura de cobertura contra el DAG 9 aristas skill→módulo medibles | 100 % confirmadas 9/9 | 100 % | 1,00× · no dice nada |
| Orden de la cascada — el TacticRanker 1 530 casos que no vio · n-gramas + 74 rasgos del estado | 1,57 posiciones | 2,44 | aporta · 3,7× menos compilados |
| La cascada sobre la sesión de Lean 30 casos · los 21 que no cierran | 40,4 s | 276 s | aporta · mismos cierres |
| Selección de premisas sin los @[simp], que simp ya tiene | 14,0 % cobertura | 11,7 % | mejora pequeña |
| Banco de fidelidad banco de 24 · corrida registrada: muestra rápida de 8 | 8/8 medidos | — | 0 infieles |
| Nombres de los nodos generados 447 identificadores con #check | 346 existen | — | 95 no existen |
| Revisión de sintaxis de la consulta 23 243 enunciados de LeanWorkbook, todos correctos | 3,6 % falsos positivos 60,8 % de caza | 3,6 % (moneda) | +57,3 puntos · aporta |
| N-gramas + rasgos del árbol → premisas 22 117 enunciados · el 80,9 % es de LAS DOS juntas: los 68 rasgos añaden +4,1 puntos sobre los n-gramas solos (76,8 %) | 80,9 % cobertura | 56,6 % (los 6 más citados) | 1,43× · aporta |
| Fibración π : Skills → Áreas 6753 pares (objeto, área debajo) | 0,1 % se levanta | 4,3 % (áreas al azar) | peor que el azar |
python scripts/recuperacion_contra_proofnet.py    # vocabulario
python scripts/funtor_dag_mathlib.py              # dependencias
python scripts/ranker_en_la_cascada.py            # el orden de la cascada
python scripts/premisas_sin_simp.py               # premisas
python -m scripts.cascada_por_estado              # la cascada en la sesión
python -m scripts.banco_fidelidad                 # fidelidad (usa API)
Todas sin API salvo la última.
Respaldo formal
62/63  operaciones del Python con teorema Lean que las respalda
    0  sorry en todo el corpus (preguntado al compilador, no con grep)
  387  teoremas en 22 archivos Lean
collectAxioms confirma que ninguna constante depende de sorryAx.
Esos 387 teoremas son los generales: valen para cualquier grafo y se prueban una vez. No dicen si este nodo es colímite de este patrón en el grafo de hoy, que es una afirmación sobre una instancia finita — y por finita, decidible. Para eso está la confirmación con el kernel:
skill, col = builder.build_colimit(patron, grafo, con_lean=True)
col.lean_verified   # True | False | None
Genera el enunciado en Lean sin import Mathlib —para que compile en
segundos, no en minutos— y lo cierra con decide, que lo comprueba el
kernel y no el compilador; native_decide metería a este último en la
base de confianza sin necesidad.
None no es False. True es «el kernel lo comprobó», False es «lo
refutó: hay un co-cono sin mediador», y None es «no se sabe» — no había
Lean, o no pudo terminar. La distinción no es teórica: a escala real el kernel
agotaba la profundidad de recursión, y sin separarlas eso se leía como que el
grafo incumplía la propiedad.
Va apagado por defecto porque cuesta un compilado, y el coste es asimétrico:
refutar es barato —decide se para en el primer contraejemplo— y confirmar
obliga a reducir la conjunción entera. Medido sobre tres colímites reales del
grafo de 353 nodos: 2,6 s, 3,4 s y 15,3 s, los tres confirmados.
El verificador se comprueba a sí mismo en tests/test_colimite_en_lean.py:
con a→i, b→i, i→x confirma, y quitando sólo i→x —con lo que x pasa a
ser co-cono sin mediador— refuta. Un verificador que no separe esos dos casos
no está verificando nada.
El orden de tácticas por área no batía a su modelo nulo
Esta medición comparaba dos reglas entre sí —2,59 y 1,29— y de ahí salía «APORTA · 2,4× menos intentos», que este repositorio publicaba como el punto mejor medido del grafo. Nunca preguntó contra qué suelo.
El suelo aparece al mirar la distribución de los 1 600 casos: simp cierra
1 532 (95,8 %). Con eso el modelo nulo es «probar simp primero y no mirar
nada más», y la regla del área pierde: 1,262 posiciones contra 1,091, con
24 casos peor y 2 mejor, diferencia media +0,172 e intervalo de confianza del
95 % en [+0,094, +0,253] — entero por encima de cero.
El mecanismo se ve en los casos: los patrones del área desplazaban a simp
justo en objetivos que simp cierra.
Quién ordena hoy. El TacticRanker —n-gramas del objetivo más 74 rasgos
estructurales del estado de prueba—, que sí bate al suyo: 1,57 posiciones
contra 2,44, y 3,7 veces menos invocaciones de Lean que el orden fijo. El orden
por área se quitó del código el 2026-09-21; su cifra y su nulo quedan en
data/descartado.json.
La sintaxis dice qué hechos hacen falta
Lo que este repositorio llamaba «sintaxis» no lo era: eran n-gramas de 1 a 4 caracteres sobre el texto sin palabras. Una bolsa de fragmentos de símbolos no sabe cuál es la relación principal del enunciado, ni si hay cuantificadores, ni qué es hipótesis y qué es tesis.
La relación sintaxis–semántica sí se puede medir aquí sin metáforas, porque hay las dos mitades: el enunciado en Lean es un objeto puramente simbólico, y los lemas que su prueba usó son lo que hizo falta en el universo matemático. 22 117 pares, 100 lemas con suficientes ejemplos:
| rasgos | cobertura | acierta alguno | |
|---|---|---|---|
| modelo nulo — los 6 más citados | — | 56,6 % | 80,3 % |
| n-gramas de caracteres | 40 000 | 76,8 % | 94,7 % |
| estructura sintáctica | 68 | 76,3 % | 94,9 % |
| las dos juntas | 40 068 | 80,9 % | 96,8 % |
Sesenta y ocho rasgos igualan a cuarenta mil, y juntos suman cuatro puntos: no son la misma información. Los n-gramas estaban aproximando la estructura de forma cara e ilegible.
Y lo que se aprende se lee, que es lo que una bolsa de n-gramas no da nunca:
| lema | el rasgo sintáctico que lo predice | qué dice |
|---|---|---|
sq_nonneg | relación principal ≤/≥ (+2,92) · en contra = (−2,54) | los cuadrados sirven para desigualdades, no para igualdades |
mul_pos | < o > en las hipótesis (+2,90) | hace falta cuando el signo viene supuesto |
Real.sqrt_nonneg | √ en la conclusión (+1,67) · en contra tipo ℤ (−1,92) | no hay raíces sobre los enteros |
mul_comm | tipo ℂ y relación = · en contra ¬ y % | no es lo que se usa en aritmética modular |
Las advertencias, porque el número solo engaña. El corpus es lean_workbook
y está dominado por desigualdades: sq_nonneg aparece en el 72 % de las
pruebas, y por eso el modelo nulo ya llega al 56,6 %. Esto mide recuperar
premisas, no cerrar pruebas. Y son 100 lemas de los 809 que aparecen — los
que tienen al menos 30 ejemplos.
Todavía no está en el camino. Es una medición, no una pieza conectada.
6bis. El decisor: qué corre, decidido por la medición
La tabla de arriba tenía filas que decían «no bate al nulo» y, aun así,
esas capacidades seguían ejecutándose: el hallazgo estaba escrito en el
informe y el if seguía en el código. nucleo/decisor.py cierra ese hueco.
La regla, y es una sola. Una capacidad corre si (1) su guarda aplica a esta consulta y (2) su evidencia gana a su modelo nulo. La (2) no se negocia. Sin evidencia, sólo corre si es gratis: no se gasta una llamada al modelo ni un compilado de Lean en algo que nadie ha medido.
El veredicto se lee, no se recuerda. Se guarda la ruta al número dentro del fichero de medición, no el número. Volver a medir cambia la decisión sola. Si una ruta deja de resolver, un test lo caza: una capacidad que se apaga en silencio es peor que no tener decisor.
Lo que apagó, y dónde quedó. Diez capacidades no batieron a su nulo —cuatro
de ellas estaban en producción— y el 2026-09-21 se quitaron del código. El
registro está en data/descartado.json: qué hacía cada
una, su cifra, su nulo y el commit donde sigue viviendo su código.
| capacidad | real | nulo |
|---|---|---|
| orden de cascada por área — estaba en producción | 1,262 | 1,091 |
| elección de imports: módulos vecinos — estaba en producción | 18 de 20 | 18 de 20 |
| dos etapas: localizar y elegir | 0,42 | 0,93 |
| recuperación léxica de lemas | 0,065 | 7,78 |
| emparejador semántico — nunca se adoptó | 13,1 % precisión | 1,45 % |
| enrutado neuronal (GNN + PPO) | 1 acción distinta | 1 de la constante |
| … y cuatro más, en el registro |
La fila del semántico decía «12 % contra 61 %», y ese 61 % no era un nulo: era el emparejador léxico. Comparar un candidato contra la versión que ya tienes no es medirlo. La de ahora es la de ProofNet, que sí trae formalizaciones de oro.
Lo que queda gobernado. El decisor sigue decidiendo qué corre —hoy, con Lean disponible, siete capacidades de trece— y sigue dejando fuera lo que no tiene evidencia y cuesta: el lazo por pasos, φ, el bloque estructural del prompt. Que ninguna fila diga ya «no bate al nulo» no es que la regla se haya relajado: es que lo que perdía se quitó.
Su propio modelo nulo es «ejecutarlo todo», y está implementado. Coste por consulta: el decisor 0 llamadas al modelo, el nulo 2; los dos, 2 compilados de Lean.
Verificar con Lean no pasa por esta regla, y se dice por qué: el nulo de «verificar» sería «no verificar», que es otro sistema, no una versión más barata de éste.
python scripts/decisor_del_sistema.py # la tabla, recalculada
6ter. La sintaxis de la consulta
Lo que había era una regex, y una regex no puede reconocer una expresión
porque una expresión es un árbol. Partía (a+b)^2 = a^2 + 2ab + b^2 por
la mitad y no encontraba nada en ∀x ∈ ℝ, x² ≥ 0: el alumno que escribe con
símbolos era invisible.
nucleo/sintaxis/ la parsea por precedencia y dice si está bien formada. La
primera versión rechazaba el 22,3 % de los enunciados correctos de
LeanWorkbook; las doce correcciones que lo bajaron al 3,6 % salieron todas
de mirar qué rechazaba —intervalos [0,∞), \mathbb{R^+}, el espaciado
\;, el guion de «Cauchy-Schwarz»—. El instrumento estaba mal, no los datos.
Sólo se avisa al alumno de delimitadores (0,6 % de falsos positivos, 99 % de caza), que además es el error más caro: un paréntesis sin cerrar hace que el modelo formalice otra fórmula, Lean verifica ésa, y la respuesta sale con el sello de «verificado» sobre un enunciado que nadie pidió. Nunca bloquea.
6quater. La fibración: el funtor existe, la fibración no
Que π : Skills → Áreas sea funtor está verificado y no basta: un funtor
que manda todo a un punto también cumple las dos leyes. La condición que dice
que la base sirve es la de fibración, demostrada en
MetamathProver/CategoryFoundations/Fibracion.lean (0 sorry).
Sobre el grafo real no se cumple: 10 de 6753 pares (0,1 %), contra el 4,3 % de barajar las áreas al azar. Y la causa no es la que parecía.
La base no es un orden. Se construye como la imagen de las flechas del
grafo y luego se cierra transitivamente, y las flechas directas entre áreas
forman una componente fuertemente conexa de 21 de las 23 áreas — sólo
Computability y OrderTheory quedan fuera. Al cerrar, 63 relaciones directas
se convierten en 462 de las 506 posibles: el 91 %.
Y los ciclos son matemática correcta, no errores de curación:
Algebra ↔ Analysis        área-algebra → spectral-theory
                          área-analysis → inner-product-spaces
Algebra ↔ CategoryTheory  exact-sequences → abelian-categories
                          functors → homological-algebra
Geometry ↔ Topology       differential-geometry → differential-topology
                          point-set-topology → differential-geometry
Sobre un preorden con una clase de equivalencia de 21 áreas, la fibración exige que todo objeto de cualquiera de ellas se levante a cualquier otra — y eso es falso: no todo concepto de álgebra depende de uno de probabilidad.
Añadir morfismos que crucen de área no puede arreglarlo, y está comprobado: la clausura transitiva es monótona, así que una arista nueva sólo puede añadir relaciones. Con 60 aristas cruzadas más, la clausura llega al 100 % y la componente se traga las 23 áreas.
Es el mismo hallazgo que dio areas_por_estructura.py sobre la taxonomía de
Mathlib —una mega-área con 918 de 1 358 conceptos— con otro disfraz: la
descomposición en ramas no es recuperable de las dependencias. El
«supergrafo unificado por un funtor» tiene el funtor; la fibración pide una
base que ordene la matemática, y el área no la ordena.
python -m scripts.base_no_es_un_orden # el diagnóstico, con su prueba
7. El lazo por pasos
El camino de arriba es un lazo por intentos: el modelo escribe la prueba entera, Lean compila el fichero y, si falla, el modelo la reescribe entera. Lo construido en septiembre de 2026 es un lazo por pasos: una táctica, un veredicto de Lean sobre el estado de prueba, y el paso siguiente sabe por qué falló el anterior. Cinco piezas, cada una con su puerta medida sin gastar API.
| paso | qué es | lo medido | estado |
|---|---|---|---|
| 1 | la sesión — un Lean que no se apaga (nucleo/lean/sesion.py) | 20 de 20 formalizaciones con el mismo veredicto que el fichero, 0 aceptadas de más | base de lo demás |
| 2 | la cascada sobre la sesión (cascada_sesion.py) | los mismos 9 cierres de 30, 0 perdidos; los fallos, 276 s → 40,4 s | encendida |
| 3 | el mediador (nucleo/lazo/) | suelo sin modelo: lo servido 9 de 20, el lazo sólo con la cascada 6, uno u otro 10 | apagado · falta su puerta con modelo |
| 4 | de dónde salen las tácticas | los vecinos de estado, +8 −0 sobre 60 estados (p = 0,008); D2 y el encoder denso, fuera | vecinos sí · los otros dos, quitados |
| 5 | φ y la explicación por paso (lazo/phi.py) | 168 estados etiquetados; sin los tipos de número, 21 contra 21 del texto | construido · exactitud sin revisar |
Dos reglas que no se negocian. Sólo Lean crea flechas: una táctica existe si y sólo si la sesión la aceptó en ese estado. Y el veredicto lo da el fichero sobre la prueba ensamblada, no la sesión — el REPL tiene registrado un caso en que aceptó pruebas incorrectas, así que la sesión busca y el fichero decide.
De las cinco piezas sólo la 2 llegó al camino servido. El resto está construido, medido y fuera hasta que la puerta del paso 3 —¿verifica más que lo servido?— se corra con un modelo; esa es la única que gasta API.
python -m scripts.sesion_contra_fichero     # la puerta del paso 1
python -m scripts.cascada_por_estado        # la del paso 2
python -m scripts.fuentes_del_lazo --n 60   # de dónde salen las tácticas
python -m scripts.phi_de_estados            # φ
8. Tests y guardianes
1312 tests en 67 suites. Los que más valen no comprueban que el código funcione, sino que no vuelva a mentir:
| guardián | qué impide |
|---|---|
test_cobertura_consultas | que el grafo deje de engancharse con las consultas reales sin avisar |
test_interpretacion | que un nodo generado se cuele como si estuviera interpretado |
test_domain_tactic_pipeline | que el prior del área vuelva a adelantar al objetivo |
| rutas absolutas | que un except mudo degrade el sistema en silencio |
| cifras declaradas | que la documentación anuncie números que ya no son ciertos |
test_alineacion | que las piezas dejen de decir lo mismo entre sí |
python -m pytest tests/ -o "addopts="
El auditor de alineación
Los tests comprueban que cada pieza cumple su contrato. Eso no basta:
FUSIONES llegó a declarar ocho fusiones con cero aplicadas —las ocho
seguían siendo nodo vivo— y ningún test falló, porque la tabla declaraba bien
y el grafo cargaba bien. Nadie preguntaba si una cosa correspondía con la otra.
python -m scripts.alineacion
Siete comprobaciones, y dos distinciones que las hacen usables:
- historia vs referencia viva. Un id retirado en prosa es trazabilidad y se
queda; en un
dictque alguien consulta, está roto. Lo separa parseando conast, no congrep. - fallo vs aviso.
homologytambién es una palabra del emparejador, no sólo una etiqueta retirada. Un auditor que se dispara con código correcto entrena a ignorarlo.
La séptima es la que más dura: cada medición escribe la huella del grafo que
midió. banco_herald.json decía «10,3 % de precisión» y la documentación lo
citaba como la cifra de hoy; se había medido sobre un grafo de 352 nodos que
todavía tenía tres que ya no existen. Ni el fichero ni la documentación mentían
por separado — faltaba la pregunta ¿y esto sobre qué grafo?, que nadie podía
hacerse porque el dato no estaba escrito. Es la disciplina del modelo nulo una
vuelta más arriba: cada cifra con su grafo.
9. Lo que se midió y se quitó
Estos resultados costaron tanto trabajo como los positivos. Están aquí para que
nadie los repita — y desde el 2026-09-21, lo que además tenía código, ya no lo
tiene: se quitó y quedó su registro en
data/descartado.json, con la cifra, el nulo y el
commit donde se puede leer entero.
La elección de imports no aporta, y no queda margen. Dar el módulo de cada
nombre ofrecido es imprescindible; proponer además módulos vecinos del grafo
empata: 18 de 20 enunciados elaboran, los mismos 18 que con un conjunto fijo de
tres módulos, y cuesta un 11 % más de tiempo. De 40 casos fallan 3: uno
necesita open Real, otro usa sintaxis vieja, y sólo uno es de imports.
Margen real: 2,5 puntos. (quitado)
Las premisas no cierran pruebas. Añadir tácticas con premisas costó 231 invocaciones extra de Lean y cerró cero. La razón es aritmética: la cobertura es del 14 %, o sea una de cada siete, y una prueba las necesita todas. Una métrica de recuperación no se traduce en cierres.
Tres emparejadores fallaron, y la causa no era el emparejador. Búsqueda
plana 43,9 %, descenso anclado en pilares 11,8 %, embeddings 11,9 % — los tres
por debajo del 79,4 % de decir siempre «álgebra». Para (a+b)² = a²+2ab+b²
no existía el nodo: las 35 skills de álgebra eran todas álgebra abstracta.
Podar por área tampoco sirve, ni acertando el área. Con localización perfecta la cobertura sube de 6,0 % a 6,8 %; el modelo nulo da 9,8 %. Afinar a sub-área empeora: el espacio se divide por cuarenta, el techo sube 0,3 puntos y acertar es la mitad de fácil. Y una sospecha mía era falsa — el 77,1 % de las premisas está en la misma área que el teorema, así que la poda no tira lo que hace falta: simplemente no ayuda.
95 de los 447 nombres generados no existen en Mathlib. Estaban deducidos
de la ruta del módulo; el filtro dejaba pasar Basic —un nombre de fichero—
igual que Polynomial —un tipo—. Sólo Lean distingue. Cuatro nodos se quedan
sin ningún nombre válido.
La recuperación de lemas por contenido pierde contra la moda. Sobre 23 243
pruebas reales: contenido 0,6 % de cobertura, ofrecer siempre los 20 lemas más
citados, 77 %. sq_nonneg no aparece en el enunciado ni tiene por qué — es una
herramienta, no un concepto del que el problema hable. (quitado)
La red neuronal aprendió una constante. El GNN + PPO se entrenó hasta el «100 % de precisión» sobre el objetivo «todo problema matemático → ASSIST», que se satisface con una constante, y eso fue lo que aprendió: la misma acción para un teorema, un saludo, una pregunta de geografía y un fragmento de Lean. El 100 % del informe de entrenamiento no era un logro, era un modelo nulo con otro nombre. El runtime ya la ignoraba con una sonda; ahora el código tampoco está. (quitado)
Un encoder de premisas entrenado para Lean tampoco entró. Dentro del lazo, con Lean de juez sobre 60 estados: 39 verificados contra 40 sin él, y 46 contra 48 junto a los vecinos de estado. Ninguna prueba cerrada usó una táctica suya. Lo que sí hizo fue gastarse el presupuesto de Lean en plantillas que no cierran. (quitado)
El bucle que no cuesta dinero
Casi todos estos negativos se midieron sin gastar una llamada al modelo: se graba la formalización una vez y se reejecuta el resto con Lean de juez. Cómo, en el flujo de trabajo.
10. El flujo de trabajo
Cómo entra —y cómo sale— una pieza de este sistema. No es una aspiración: es lo que hacen los guardianes de la sección 8.
El ciclo de una capacidad
     escribir la puerta          ¿qué mediría que esto sirve, y contra qué suelo?
            ↓                    se escribe ANTES de medir, en el docstring del banco
        construirla
            ↓
       medir sin API             Lean de juez · el nulo al lado · la huella del grafo
            ↓
     ┌──── ¿bate a su nulo? ────┐
     │ sí                       │ no
     ↓                          ↓
  cablearla y                quitarla, y dejar
  declararla en              su cifra en
  nucleo/decisor.py          data/descartado.json
La puerta se escribe antes. Los bancos de scripts/ llevan en su
docstring qué miden, contra qué nulo y —los del lazo por pasos, donde la
disciplina está más apretada— qué resultado haría entrar la pieza. Escribirla después
es elegir la regla que te da la razón — y este repositorio ya se lo hizo a sí
mismo: la medición del orden de tácticas comparaba dos reglas entre sí, sin
suelo, y publicó «2,4× mejor» durante meses.
El veredicto se lee, no se recuerda. El decisor guarda la ruta al número
dentro del fichero de medición, no el número. Volver a medir cambia la conducta
sin tocar código, y test_ninguna_ruta_de_evidencia_esta_rota falla si una ruta
deja de resolver: una capacidad que se apaga en silencio sería peor que no
tener decisor.
Y si pierde, se va. Hasta el 21 de septiembre de 2026 lo que perdía se quedaba apagado «por si acaso»; hoy se borra y queda el registro —qué hacía, su cifra, su nulo y el commit donde vive su código—. Diez capacidades salieron así (§9). Descartar no es borrar: sin el registro, dentro de seis meses alguien vuelve a construir lo mismo.
Medir sin gastar
Casi todo se mide con Lean de juez y cero llamadas al modelo. El truco es grabar la formalización una vez y reejecutar el resto cuantas veces haga falta:
METAMAT_GRABAR=1 python -m nucleo chat     # graba mientras trabajas
python scripts/replay.py                   # reproduce el camino servido, sin API
La frontera está donde tiene que estar: se graba el código del modelo antes de que Lean lo vea. Si el gancho se moviera detrás, el replay mediría el sistema contra su propia salida — hay un test que lo impide.
Lo único que sí gasta: el banco de fidelidad y la puerta con modelo del lazo por pasos (§7).
Antes de cada commit
python -m pytest tests/ -o "addopts="      # 1300 tests · 66 suites
python -m scripts.alineacion               # ¿las piezas dicen lo mismo entre sí?
python -m scripts.auditar_artefacto        # ¿cada cifra publicada sigue siendo la suya?
python -m scripts.cifras_de_tests          # reescribe los recuentos en los 7 sitios
python -m scripts.frase_del_catalogo       # reescribe la frase del decisor
Los dos primeros son de naturaleza distinta y hacen falta los dos: los tests
comprueban que cada pieza cumple su contrato, y el auditor que las piezas
se corresponden entre sí. FUSIONES llegó a declarar ocho fusiones con cero
aplicadas sin que fallara un solo test, porque la tabla declaraba bien y el
grafo cargaba bien; nadie preguntaba si una cosa correspondía con la otra.
Los tres últimos reescriben documentación desde el código: los recuentos de tests y la frase del catálogo del decisor no se escriben a mano, porque una cifra escrita a mano envejece en silencio.
Dónde queda cada cosa
| qué | dónde |
|---|---|
| cada medición, con su método en el docstring | scripts/*.py |
| su resultado, con la huella del grafo que midió | data/*.json |
| lo que se quitó, con su cifra y su commit | data/descartado.json |
| qué corre y por qué, por consulta | nucleo/decisor.py |
| el documento largo, y su fuente | artefacto · docs/arquitectura_nle.html |
La huella no es un adorno. banco_herald.json decía «10,3 % de precisión» y la
documentación lo citaba como la cifra de hoy; se había medido sobre un grafo de
352 nodos con tres que ya no existen. Ni el fichero ni el documento mentían por
separado — faltaba la pregunta ¿y esto sobre qué grafo?.
El día a día en esta máquina
El sistema arranca solo al iniciar sesión (Programador de tareas → el lanzador
Metamatematico.vbs, que llama a Metamatematico.ps1) y queda en
http://localhost:8501. El acceso directo del escritorio abre eso mismo.
# reiniciarlo tras tocar el código (mata lo que escuche en 8501 y relanza)
wscript.exe E:\Metamatematico\Metamatematico.vbs
# los registros
Get-Content E:\Metamatematico\logs\streamlit_error.log -Tail 20
11. Instalación y uso
git clone https://github.com/metamatematico/Metamatematico---Razonamiento-Formal-con-Lean.git
cd Metamatematico---Razonamiento-Formal-con-Lean
pip install -r requirements.txt

# Lean 4 + Mathlib
lake update && lake build          # 20-30 min la primera vez

# la clave de API, en .env (gitignored)
echo "ANTHROPIC_API_KEY=sk-..." > .env

streamlit run app.py               # interfaz
python -m nucleo chat              # REPL
Los índices derivados de Mathlib se reconstruyen con:
python -m scripts.mapa_modulos_mathlib
python scripts/construir_lista_lemas.py --escribir
python scripts/construir_indice_premisas.py
lake exe graph --to Mathlib data/mathlib_imports.dot
12. Estructura del repositorio
nucleo/
  core.py                 el orquestador: Nucleo.process()
  decisor.py              qué capacidad corre, leyendo su medición
  rutas.py                dónde está cada cosa, sin rutas absolutas
  graph/                  la categoría de conceptos
    interpretacion.py     el veredicto: qué es cada nodo, y su `teoria`
    complexity.py         colímites, orden, emergencia
    estados.py            la categoría de estados de prueba
  lean/
    client.py             habla con Lean — el fichero, que es quien decide
    sesion.py             el REPL que no se apaga — la sesión, que busca
    cascada_sesion.py     las 12 tácticas sobre la sesión
    solver_cascade.py     la cascada y el TacticRanker que la ordena
    premisas.py           qué lemas citar cuando la táctica desnuda no basta
  lazo/                   el lazo por pasos: mediador, proponentes, φ
  sintaxis/               el árbol de la consulta, antes de gastar nada
  pillars/
    math_domains.py       los 206 nodos curados
    mathlib_taxonomy.py   los 125 generados (GENERADO — no editar a mano)
    grafo_curado.py       el grafo curado a solas, que miden los tests

scripts/                  cada medición, con su método en el docstring
MetamathProver/           387 teoremas Lean · 22 archivos
tests/                    1312 tests en 67 suites
data/                     índices derivados (los grandes van en .gitignore)
  descartado.json         lo que se midió, no batió a su nulo y se quitó
13. Lo que no está
Sin respuesta todavía. Si el vocabulario del paso 1 se traduce en más verificaciones. Es la única pregunta que necesita llamar al modelo, y está bloqueada por presupuesto. Lo que hay: en 8 casos fáciles apagar el núcleo entero no cambia ningún veredicto y el sistema completo tarda más — n=8 con efecto techo, no concluyente.
Identificado y sin arreglar.
El emparejamiento consulta→concepto: 15 de 24 consultas reales no activan ninguna skill.Arreglado — el silencio pasó del 27,1 % al 5,8 % sobre 3 000 consultas. Lo que queda: no hay lematización, así queprimossigue sin casar conprimo.- Los pasos 1 y 3 no son independientes. El 3 reusa el
contextdel 1 (core.py:1858), así que si el emparejamiento falla, el 3 hereda el fallo. Se venían describiendo como tres actuaciones separadas y son dos más una. - Las tácticas como nodos: 552 aristas entrando en 9 sumideros. La categoría donde son flechas ya existe —la de estados de prueba— y el lazo por pasos la construye en vivo; el defecto es de este grafo, no del sistema.
- Los nombres de los 125 nodos generados están deducidos de la ruta del
módulo, no comprobados con
#check. Por eso no se inyectan: al activarlos la precisión caía por debajo del azar. - Seis dependencias siguen bajo sospecha de ir al revés.
Lo que el sistema no hace.
- No demuestra teoremas por sí solo: formaliza y verifica.
- El grafo no decide qué es cierto en ningún punto. Eso es Lean, siempre.
- Sin API no hay formalización, ni chat, ni banco de fidelidad. Lo que sigue vivo sin ella es validar y mejorar el núcleo.
Licencia MIT · Leonardo Jiménez Martínez, BIOMAT — Centro de Biomatemáticas